你有没有想过,自己电脑里的 NVIDIA 显卡,可能并没有发挥出全部性能?尤其是在本地部署 AI 大模型时,显卡的算力表现直接决定了模型的推理速度和使用体验。
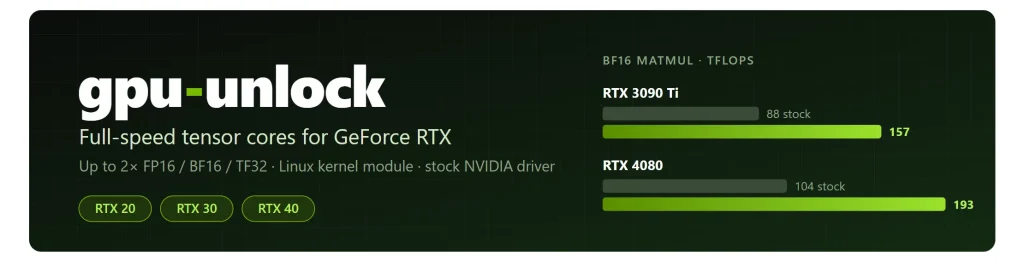
最近,一个名为 GPU-UNLOCK 的开源项目引起了我的注意,它尝试通过解除显卡的部分性能限制,释放更多 GPU 算力,让本地运行大模型变得更加高效。更重要的是,它提供了相对简单的自动化操作方式,不需要复杂的手动配置。如果你也喜欢在自己的电脑上折腾本地 AI、大语言模型,那么这个工具值得一试!
安装教程
一、下载 GPU-UNLOCK 显卡解锁器
支持的GPU
| 版本 | 显卡 | 状况 |
|---|---|---|
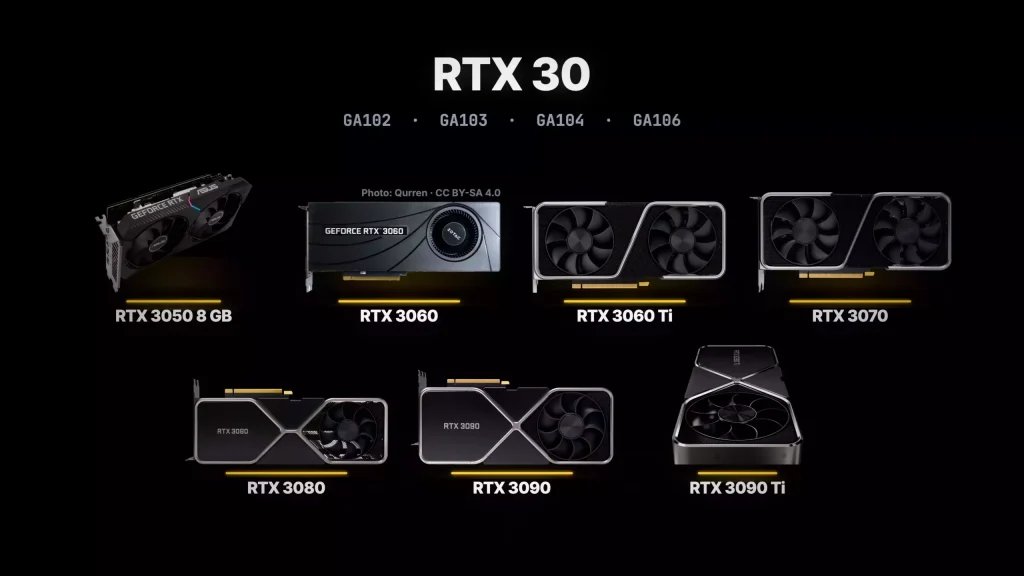
| (RTX 30) | RTX 3050、3060、3060 Ti、3070、3070 Ti、3080、3080 Ti、3090、3090 Ti 以及 RTX 3070/3080 笔记本电脑 GPU | 稳定,100+ 用户报告 |
| (RTX 40) | RTX 4060、4060 Ti、4070、4070 SUPER、4070 Ti、4070 Ti SUPER、4080、4080 SUPER、4090、4090 D、RTX 4050/4060 笔记本电脑显卡 | 实验 |
| (RTX 20) | RTX 2060、2060 SUPER、2070、2070 SUPER、2080、2080 SUPER、2080 Ti、Titan RTX | 实验 |
| Blackwell(RTX 50) | 不支持 |
注意:目前在Windows系统上主要支持30系显卡,如果想获得更广泛的解锁支持,推荐使用Linux系统
你将获得什么
张量核心频率翻倍。具体提升幅度取决于你的工作负载中有多少是 FP16/BF16/TF32 矩阵运算,以及显卡是否有足够的性能余量来运行这些运算。
稠密矩阵乘法(FP32 累积,股票功率限制):
| 卡片 | BF16之前 | BF16 之后 | 获得 |
|---|---|---|---|
| RTX 3060 12 GB | 27 TFLOPS | 51 TFLOPS | +87% |
| RTX 3060 Ti | 37 TFLOPS | 68 TFLOPS | +82% |
| RTX 3070 | 40 TFLOPS | 72 TFLOPS | +81% |
| RTX 3080 10 GB | 65 TFLOPS | 113 TFLOPS | +73% |
| RTX 3090 | 75 TFLOPS | 125 TFLOPS | +65% |
| RTX 3090 Ti (450 W) | 88 TFLOPS | 157 TFLOPS | +80% |
| RTX 4070 Ti | 81 TFLOPS | 150 TFLOPS | +84% |
| RTX 4080 | 104 TFLOPS | 193 TFLOPS | +87% |
| RTX 4090 | 165 TFLOPS | 329 TFLOPS | +100%(MMA峰值速率) |
RTX 4090 的功耗先于张量核心耗尽,因此,在默认功耗限制下,大容量 GEMM 内存的增益远低于峰值速率所显示的增益。
实际工作负载:
| 工作量 | 典型加速 |
|---|---|
| LLM 预填充/提示处理,FP16/BF16 或 AWQ/GPTQ(vLLM、PyTorch、Transformers) | +25–55% |
| 到达第一个代币的时间 | 降低 25-30% |
| LoRA 和 BF16 中的全面微调 | +25–50% |
| 图像生成,FP16/BF16(ComfyUI 中的 SDXL、SD 1.5、Krea、DiT 模型) | +30–55% |
| 视频生成,BF16 计算(WAN 2.2) | +15-20% |
| FlashAttention / SDPA 内核 | +50–60% |
| llama.cpp / 带有量化 GGUF 的 Ollama | 0-15%,主要在长上下文中 |
| LLM解码/令牌生成(内存密集型) | 无变化 |
| INT8、FP8 和 INT4 型号 | 无变化 |
| 游戏和FP32 CUDA | 无变化 |
前后输出结果完全相同,只有速度有所变化。这些数据来自 用户提交的兼容性报告,您可以在报告中找到完整的基准测试详情并发布您自己的测试结果。
二、安装 Python 环境
官方要求是安装 Python 3.10 或更高版本,如果你电脑上已经安装了python环境,可以直接跳过第2个步骤,如果没安装,需要通过下方的链接来进行下载下必备的环境。
Python 官方下载:【点击前往】
进入后选择对应的版本,Windows 推荐选择x64位的版本
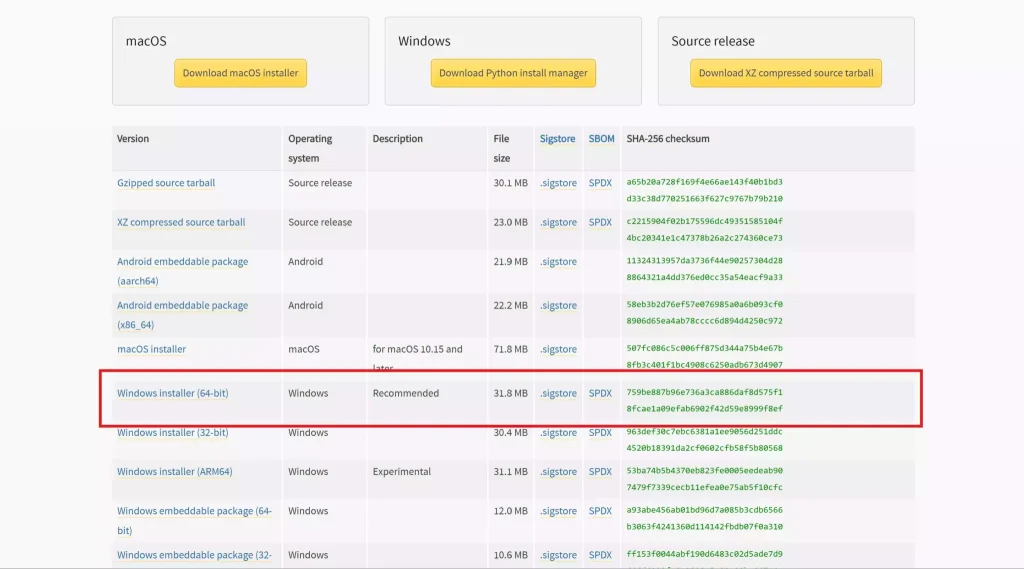
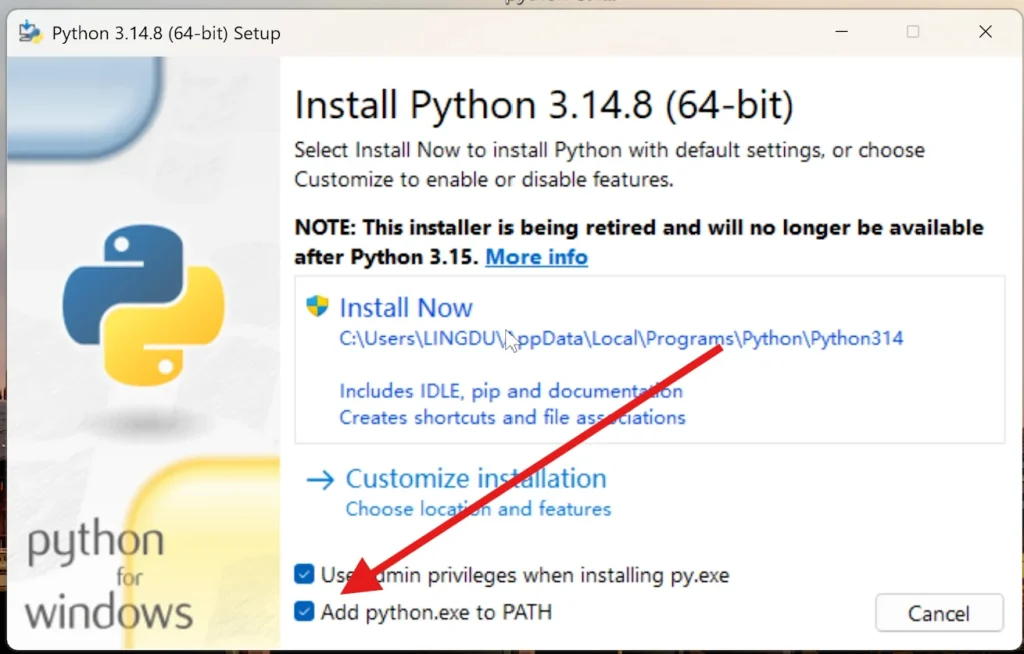
注意:安装的时候务必勾选这里面的2个选项,否则后面可能会出错!
三、下载 LocModel 本地模型部署工具
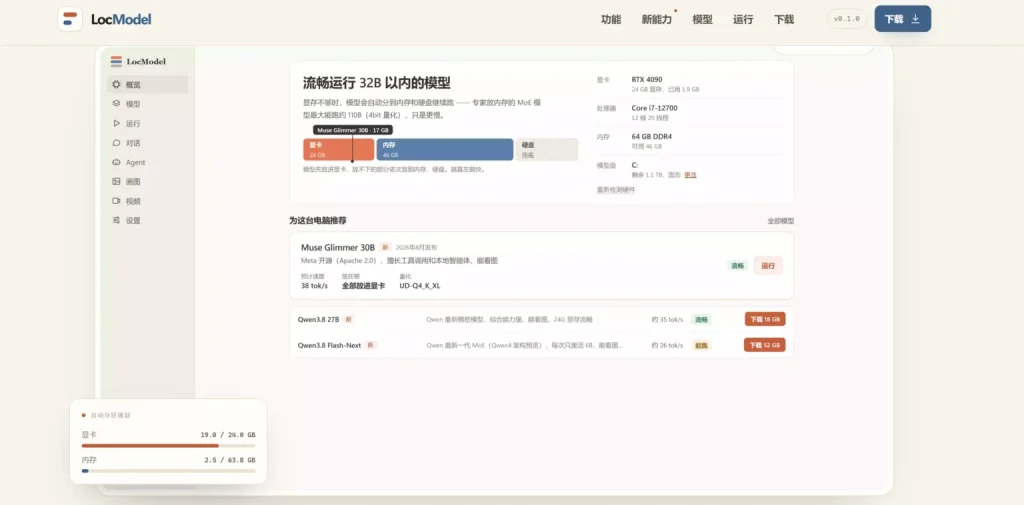
LocModel 是一款免费的开源模型加载软件,安装后可以自动识别你的硬件,推荐最合适的开源模型,装好推理引擎。支持在线下载或导入 GGUF,点一下,就在本地跑起来。现在,它也学会了画图、生成视频和替你动手的Agent。
LocModel 官方下载:https://locmodel.com
一键解锁命令:
只要你的显卡在解锁的范围内,那么就可以实现一键解锁GPU的算力,让你的显卡跑本地大模型的算力免费提升将近50%左右!
亲测:解锁后跑 BF16的 Z-Image Turbo 文生图 模型 ,我的12G的RTX3060的生成速度可以提升将近一半左右,效果立竿见影!
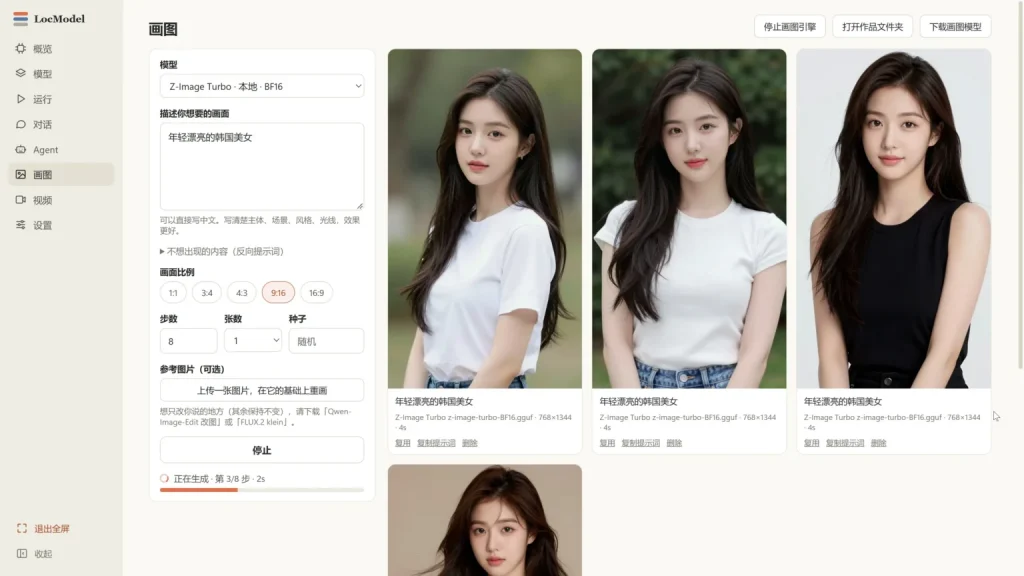
当然我们可以跑F16的Qwen 3.5 9B 模型,它的效果可能没有文生图片模型那么明显,但是也是有一定的加速效果的。
开源模型下载:【点击前往】
如果你显存比较小,建议选择更小的模型,否则可能会爆显存或速度不够快~
Linux 系统下解锁步骤
开源项目:https://github.com/Zagitta/gpu-unlock#how-to-install
执行下方的命令:
然后将其添加gpu_unlock.targets=all到内核命令行,并保留现有选项:
- GRUB(Debian/Ubuntu/Mint):将其添加到 中
GRUB_CMDLINE_LINUX_DEFAULT,/etc/default/grub然后运行sudo update-grub。 - GRUB(Arch/CachyOS):进行相同的编辑,然后运行
sudo grub-mkconfig -o /boot/grub/grub.cfg。 - Fedora/RHEL:运行
sudo grubby --update-kernel=ALL --args="gpu_unlock.targets=all"。 - systemd-boot:将其添加到
options启动项中的行(bootctl status显示其位置)。 - UKI / 生成的条目:将其添加到
/etc/kernel/cmdline并重新生成您的启动映像/条目(例如,sudo mkinitcpio -P对于 mkinitcpio UKI)。
原创文章,作者:极客智库 ,如若转载,请注明出处:https://www.jikezhiku.com/2272.html
